
تذكّر كيف تعلّمت ركوب الدراجة. في البداية كان أبوك أو أخوك الكبير يمسك المقعد من الخلف ويقول لك: «ميّل يمين.. لا، شوي يسار». ثم جاء يوم تركك فيه دون أن تنتبه، فسقطت مرة ومرتين، وفي الثالثة بقيت واقفًا. وفي الطريق كنت تراقب الأطفال الآخرين في الحارة: من يقود بسرعة، ومن يحب الدوران، ومن يخاف من المطبات، دون أن يشرح لك أحد ذلك.
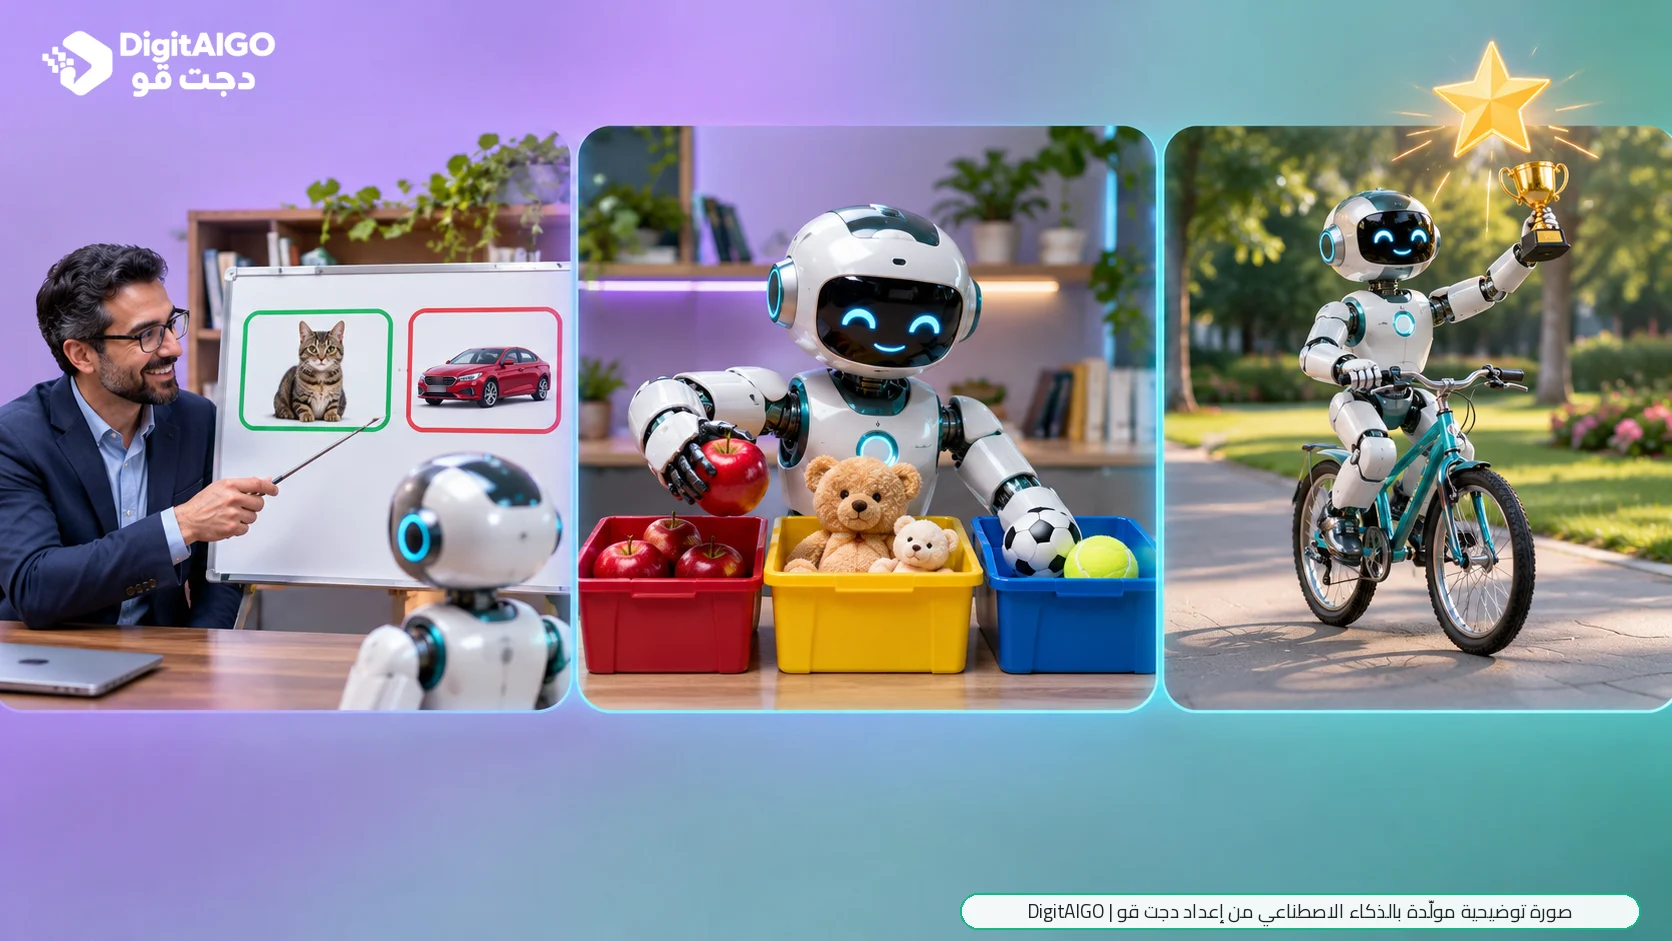
في هذه الحكاية الصغيرة ثلاث طرق مختلفة للتعلّم: معلّم يصحح لك، وملاحظة تكتشف بها الأنماط وحدك، وتجربة تتعلم فيها من السقوط والنجاح. والمدهش أن الآلة تتعلم بالطرق الثلاث نفسها تقريبًا.
في الدرس الأول عرفنا أن الآلة تتعلم من الأمثلة، وفي الدرس الثاني عرفنا أن هذه الأمثلة هي البيانات التي نصنعها كل يوم. واليوم نفتح «الصندوق» ونرى الطرق الثلاث التي تتعلم بها الآلة من هذه البيانات، وهي ما يسميه المتخصصون أنواع تعلم الآلة.
محتويات الدرس
الطريقة الأولى: التعلّم بمعلّم (Supervised Learning)
هذه أقرب الطرق إلى مدرستنا. تعطي الآلة أمثلة كثيرة، ومع كل مثال الإجابة الصحيحة: «هذه صورة قطة»، «هذه رسالة احتيال»، «هذا البيت بيع بـ 900 ألف». تحاول الآلة أن تخمّن، ثم تقارن تخمينها بالإجابة الصحيحة، وتعدّل نفسها قليلًا. وتكرر ذلك آلاف أو ملايين المرات حتى يقلّ خطؤها.
وهنا يعود «الوسم» الذي تعرفنا عليه في الدرس الثاني. فالفرق الأساسي بين هذه الطريقة والطريقة الثانية، كما تشرحه IBM، أن التعلم بمعلّم يستخدم بيانات موسومة، أي معروفة الإجابة، بينما لا يستخدمها التعلم دون معلّم. وتلاحظ IBM أن نماذج التعلم بمعلّم تكون عادة أدق، لكنها تحتاج إلى جهد بشري مسبق لوسم البيانات.
أين تراها في حياتك؟
- تطبيق البنك الذي يرسل لك تنبيهًا: «هل أنت من قام بهذه العملية؟». تعلّم النظام من آلاف العمليات التي وُسمت سابقًا بأنها احتيال أو سليمة.
- تحويل صوتك إلى نص في الجوال: تعلّمت الآلة من تسجيلات صوتية مرفقة بنصّها المكتوب.
- تقدير سعر سيارة مستعملة في تطبيقات البيع: تعلّم النظام من سيارات بيعت فعلًا وعُرف سعرها.
نقطة ضعفها: الإجابات الصحيحة مكلفة. فأحدهم يجب أن يجلس ويقول للآلة «هذه قطة» آلاف المرات. وإذا أخطأ المعلّم في الوسم، تعلّمت الآلة الخطأ معه.
الطريقة الثانية: التعلّم دون معلّم (Unsupervised Learning)
الآن نعطي الآلة كومة كبيرة من البيانات بلا إجابات، ونقول لها: «رتّبيها». لا أحد يخبرها ما الصحيح، فتبحث هي عن التشابه والاختلاف، وتجمع المتشابه في مجموعات.
تخيّل أنك أفرغت على الطاولة كيسًا فيه حلويات العيد من عشرة أنواع، وطلبت من طفل لا يعرف أسماءها أن يرتبها. لن يقول «هذا معمول وهذا غريبة»، لكنه سيضع المتشابه شكلًا ولونًا وحجمًا في كومة واحدة. هذا بالضبط ما تفعله الآلة في التعلّم دون معلّم: تكتشف المجموعات، ثم نأتي نحن ونسمّيها.
أين تراها في حياتك؟
- تطبيق الصور في جوالك حين يجمع صور الشخص نفسه معًا قبل أن تكتب اسمه: يكتشف التشابه أولًا، ثم يسألك «من هذا؟».
- المتاجر الإلكترونية التي تقسّم عملاءها إلى مجموعات حسب سلوك الشراء، دون أن تعرف مسبقًا ما هذه المجموعات.
- أنظمة الحماية التي تلاحظ أن جهازًا في الشبكة «يتصرف بشكل مختلف» عن البقية، فتنبّه إليه.
نقطة ضعفها: الآلة تكتشف أن هناك مجموعات، لكنها لا تعرف معناها. وقد تجمع أشياء لسبب لا يهمنا، كأن تجمع الصور حسب الإضاءة لا حسب الأشخاص. ولذلك يبقى للإنسان دور في تفسير النتيجة.
الطريقة الثالثة: التعلّم بالتجربة والمكافأة (Reinforcement Learning)
هذه طريقة الدراجة. لا أحد يعطي الآلة الإجابة الصحيحة، ولا كومة بيانات لترتيبها. بل نضعها في «بيئة» ونتركها تجرب: كل خطوة تقربها من الهدف تأخذ عليها مكافأة، وكل خطوة سيئة تخسر بسببها. ومع آلاف المحاولات تتعلم أي التصرفات تجلب المكافأة.
وأشهر مثال على ذلك برنامج AlphaGo Zero من DeepMind. ففي أكتوبر 2017 أعلنت الشركة أنه تعلّم لعبة «غو» الصينية المعقدة دون أن يرى مباراة بشرية واحدة. بدأ بلوحة فارغة وقواعد اللعبة فقط، ثم لعب ملايين المباريات ضد نفسه، يتعلم من كل واحدة. وبعد ثلاثة أيام فقط من اللعب ضد نفسه، هزم النسخة السابقة التي كانت قد هزمت بطل العالم لي سيدول، بنتيجة 100 مباراة مقابل لا شيء.
أين تراها في حياتك؟
- الروبوتات التي تتعلم المشي أو الإمساك بالأشياء بالمحاولة والخطأ في بيئات محاكاة.
- أنظمة التحكم التي تتعلم تقليل استهلاك الطاقة في المباني ومراكز البيانات.
- وجزء من تدريب المساعدات الذكية مثل ChatGPT، وهذا ما نشرحه الآن.
نقطة ضعفها: التجربة تحتاج وقتًا ومحاولات هائلة، ولا يمكن السماح بها في كل مكان. فلن نترك سيارة تتعلم القيادة بالسقوط في الشارع! ولذلك يجري أغلب هذا التدريب في بيئات محاكاة أولًا.
مقارنة سريعة: الطرق الثلاث في جدول
| الطريقة | ماذا تعطي الآلة؟ | ماذا تتعلم؟ | مثال من حياتنا |
|---|---|---|---|
| بمعلّم | أمثلة مع إجاباتها الصحيحة | أن تتوقع الإجابة لأمثلة جديدة | تنبيه البنك عن عملية مشبوهة |
| دون معلّم | بيانات بلا إجابات | أن تكتشف المجموعات والأنماط المخفية | تجميع صور الشخص نفسه في الجوال |
| بالتجربة والمكافأة | بيئة وهدف ومكافأة | أفضل تصرف خطوة بعد خطوة | برنامج تعلّم لعبة بالتجربة |
وكيف تعلّم ChatGPT؟ الطرق الثلاث معًا
المساعدات الذكية التي نستخدمها اليوم لا تعتمد على طريقة واحدة، بل تمزج بينها. وأوضح وصف رسمي لذلك في ورقة InstructGPT التي نشرتها OpenAI في يناير 2022، وهي الأساس الذي بُني عليه ChatGPT بعدها:
- أولًا، تعلّم بمعلّم: كتب أشخاص إجابات نموذجية لأسئلة حقيقية، وتعلّم النموذج من هذه الأمثلة كيف يجيب.
- ثانيًا، تعلّم بالتجربة والمكافأة مع البشر: كتب النموذج عدة إجابات للسؤال نفسه، ورتّبها أشخاص من الأفضل إلى الأسوأ. ثم صار هذا الترتيب «مكافأة» يتحسن النموذج على أساسها. وتسمّي OpenAI هذه التقنية التعلم المعزّز من ملاحظات البشر (RLHF).
والنتيجة التي ذكرتها الورقة لافتة: فضّل المقيّمون إجابات نموذج InstructGPT الصغير على إجابات GPT-3 الأكبر منه بمئة مرة. أي أن طريقة التعليم صنعت فرقًا أكبر من حجم «الدماغ» نفسه.
وحين تضغط 👍 أو 👎 تحت إجابة في ChatGPT، فأنت تشارك في شكل مبسّط من هذه الفكرة: ملاحظة بشرية تساعد الشركة على معرفة الإجابات الأفضل.
تمرين: صنّف هذه الأمثلة
اقرأ الأمثلة الستة، وحدد طريقة التعلّم في كل منها: بمعلّم، أو دون معلّم، أو بالتجربة والمكافأة. ثم قارن إجاباتك بالحل في الأسفل.
- نظام يتعلم تمييز أوراق النخيل المصابة بالسوسة من صور صنّفها مهندسون زراعيون.
- تطبيق موسيقى يجمع الأغاني في «أجواء» متشابهة دون أن يخبره أحد بأسماء هذه الأجواء.
- روبوت مستودع يتعلم أقصر طريق بين الرفوف، ويكسب نقاطًا كلما وصل أسرع.
- برنامج يتوقع درجة الطالب في الاختبار النهائي من درجات طلاب سابقين معروفة نتائجهم.
- نظام بنكي يكتشف أن مجموعة من الحسابات تتصرف بطريقة متشابهة وغريبة، دون أن يعرف مسبقًا أنها احتيال.
- شخصية في لعبة فيديو تتعلم تجاوز المراحل بعد آلاف المحاولات الفاشلة.
الحل: (1) بمعلّم، لأن الصور موسومة من مهندسين. (2) دون معلّم، لأنها مجموعات اكتشفها النظام وحده. (3) بالتجربة والمكافأة. (4) بمعلّم، لأن النتائج السابقة معروفة. (5) دون معلّم، لأنه اكتشف النمط الغريب وحده. (6) بالتجربة والمكافأة.
إن أصبت في خمسة أو ستة، فقد فهمت الفكرة تمامًا. وإن اختلطت عليك (5)، فلا بأس، فهي المثال الأصعب: لو كان النظام قد تعلّم من عمليات احتيال سابقة معروفة، لصار تعلّمًا بمعلّم.
الخلاصة
أنواع تعلم الآلة ثلاثة، وكلها تشبه طرقنا نحن: من معلّم يعطيها الإجابات، أو بملاحظة الأنماط وحدها، أو بالتجربة والمكافأة. ولكل طريقة قوتها وحدودها، والأنظمة الحديثة مثل ChatGPT تجمع بينها. وإذا فهمت هذه الطرق الثلاث، صار سهلًا عليك أن تفهم أي خبر جديد عن الذكاء الاصطناعي: اسأل نفسك فقط «من أين تعلّم هذا النظام؟ وبأي طريقة؟».
في الدرس القادم: نتعرف على أنواع وكلاء الذكاء الاصطناعي، من الوكيل البسيط الذي يرد بقاعدة ثابتة، إلى الوكيل «المتعلّم» الذي يستخدم ما عرفناه اليوم. وإن أردت مقدمة سريعة قبله، فاقرأ دليلنا: وكلاء الذكاء الاصطناعي: ما هم؟ وكيف يُنجزون المهام نيابة عنك بأمان؟
أسئلة شائعة
أي أنواع تعلم الآلة هو الأفضل؟
لا يوجد نوع أفضل مطلقًا، بل نوع أنسب للمشكلة. فإذا كانت عندك أمثلة بإجاباتها، فالتعلم بمعلّم غالبًا أدق. وإذا كانت عندك بيانات كثيرة بلا إجابات، فالتعلم دون معلّم يكشف ما فيها. وإذا كانت المهمة سلسلة قرارات نحو هدف، فالتعلم بالتجربة والمكافأة هو الأنسب.
هل هناك أنواع غير هذه الثلاثة؟
نعم، هناك طرق تقع بينها، مثل «التعلم شبه الموجّه» الذي يستخدم قليلًا من البيانات الموسومة مع كثير من غير الموسومة. لكن الطرق الثلاث هي الأساس الذي تُبنى عليه البقية، وهي ما يكفيك في هذه المرحلة.
هل تعلّم الآلة يشبه تعلّم الإنسان فعلًا؟
يشبهه في الفكرة العامة فقط. فالإنسان يتعلم من مثال أو مثالين، بينما تحتاج الآلة عادة إلى آلاف أو ملايين الأمثلة. والتشبيه يساعدنا على الفهم، لكنه لا يعني أن الآلة «تفكر» مثلنا.
المعلومات في هذا الدرس محدّثة حتى 20 نوفمبر 2026.
المصادر
- IBM: Supervised versus unsupervised learning: What’s the difference?
- OpenAI: Aligning language models to follow instructions (يناير 2022)
- Ouyang وآخرون: Training language models to follow instructions with human feedback (2022)
- MIT Technology Review: AlphaGo Zero Shows Machines Can Become Superhuman Without Any Help (أكتوبر 2017)
- Google DeepMind: AlphaGo Zero: Starting from scratch
